AI 客服的实时视频与语音应答
银行网点屏幕中的 AI 柜员能听懂客户的话,并用语音和视频介绍存款、定期储蓄、贷款等产品;在这项服务中,我们开发了应用端环节:把客户的声音发送到服务器,再接收并播放 AI 生成的柜员应答视频。客户说完话后视频若迟迟不开始,对话就变成了等待,因此我们专注于缩短发送语音与接收视频之间的延迟。从接收麦克风输入并压缩、通过实时连接传往服务器,到立即播放返回的视频,每个阶段都分开设计。语音识别与视频合成由服务器负责,我们的范围是应用端。
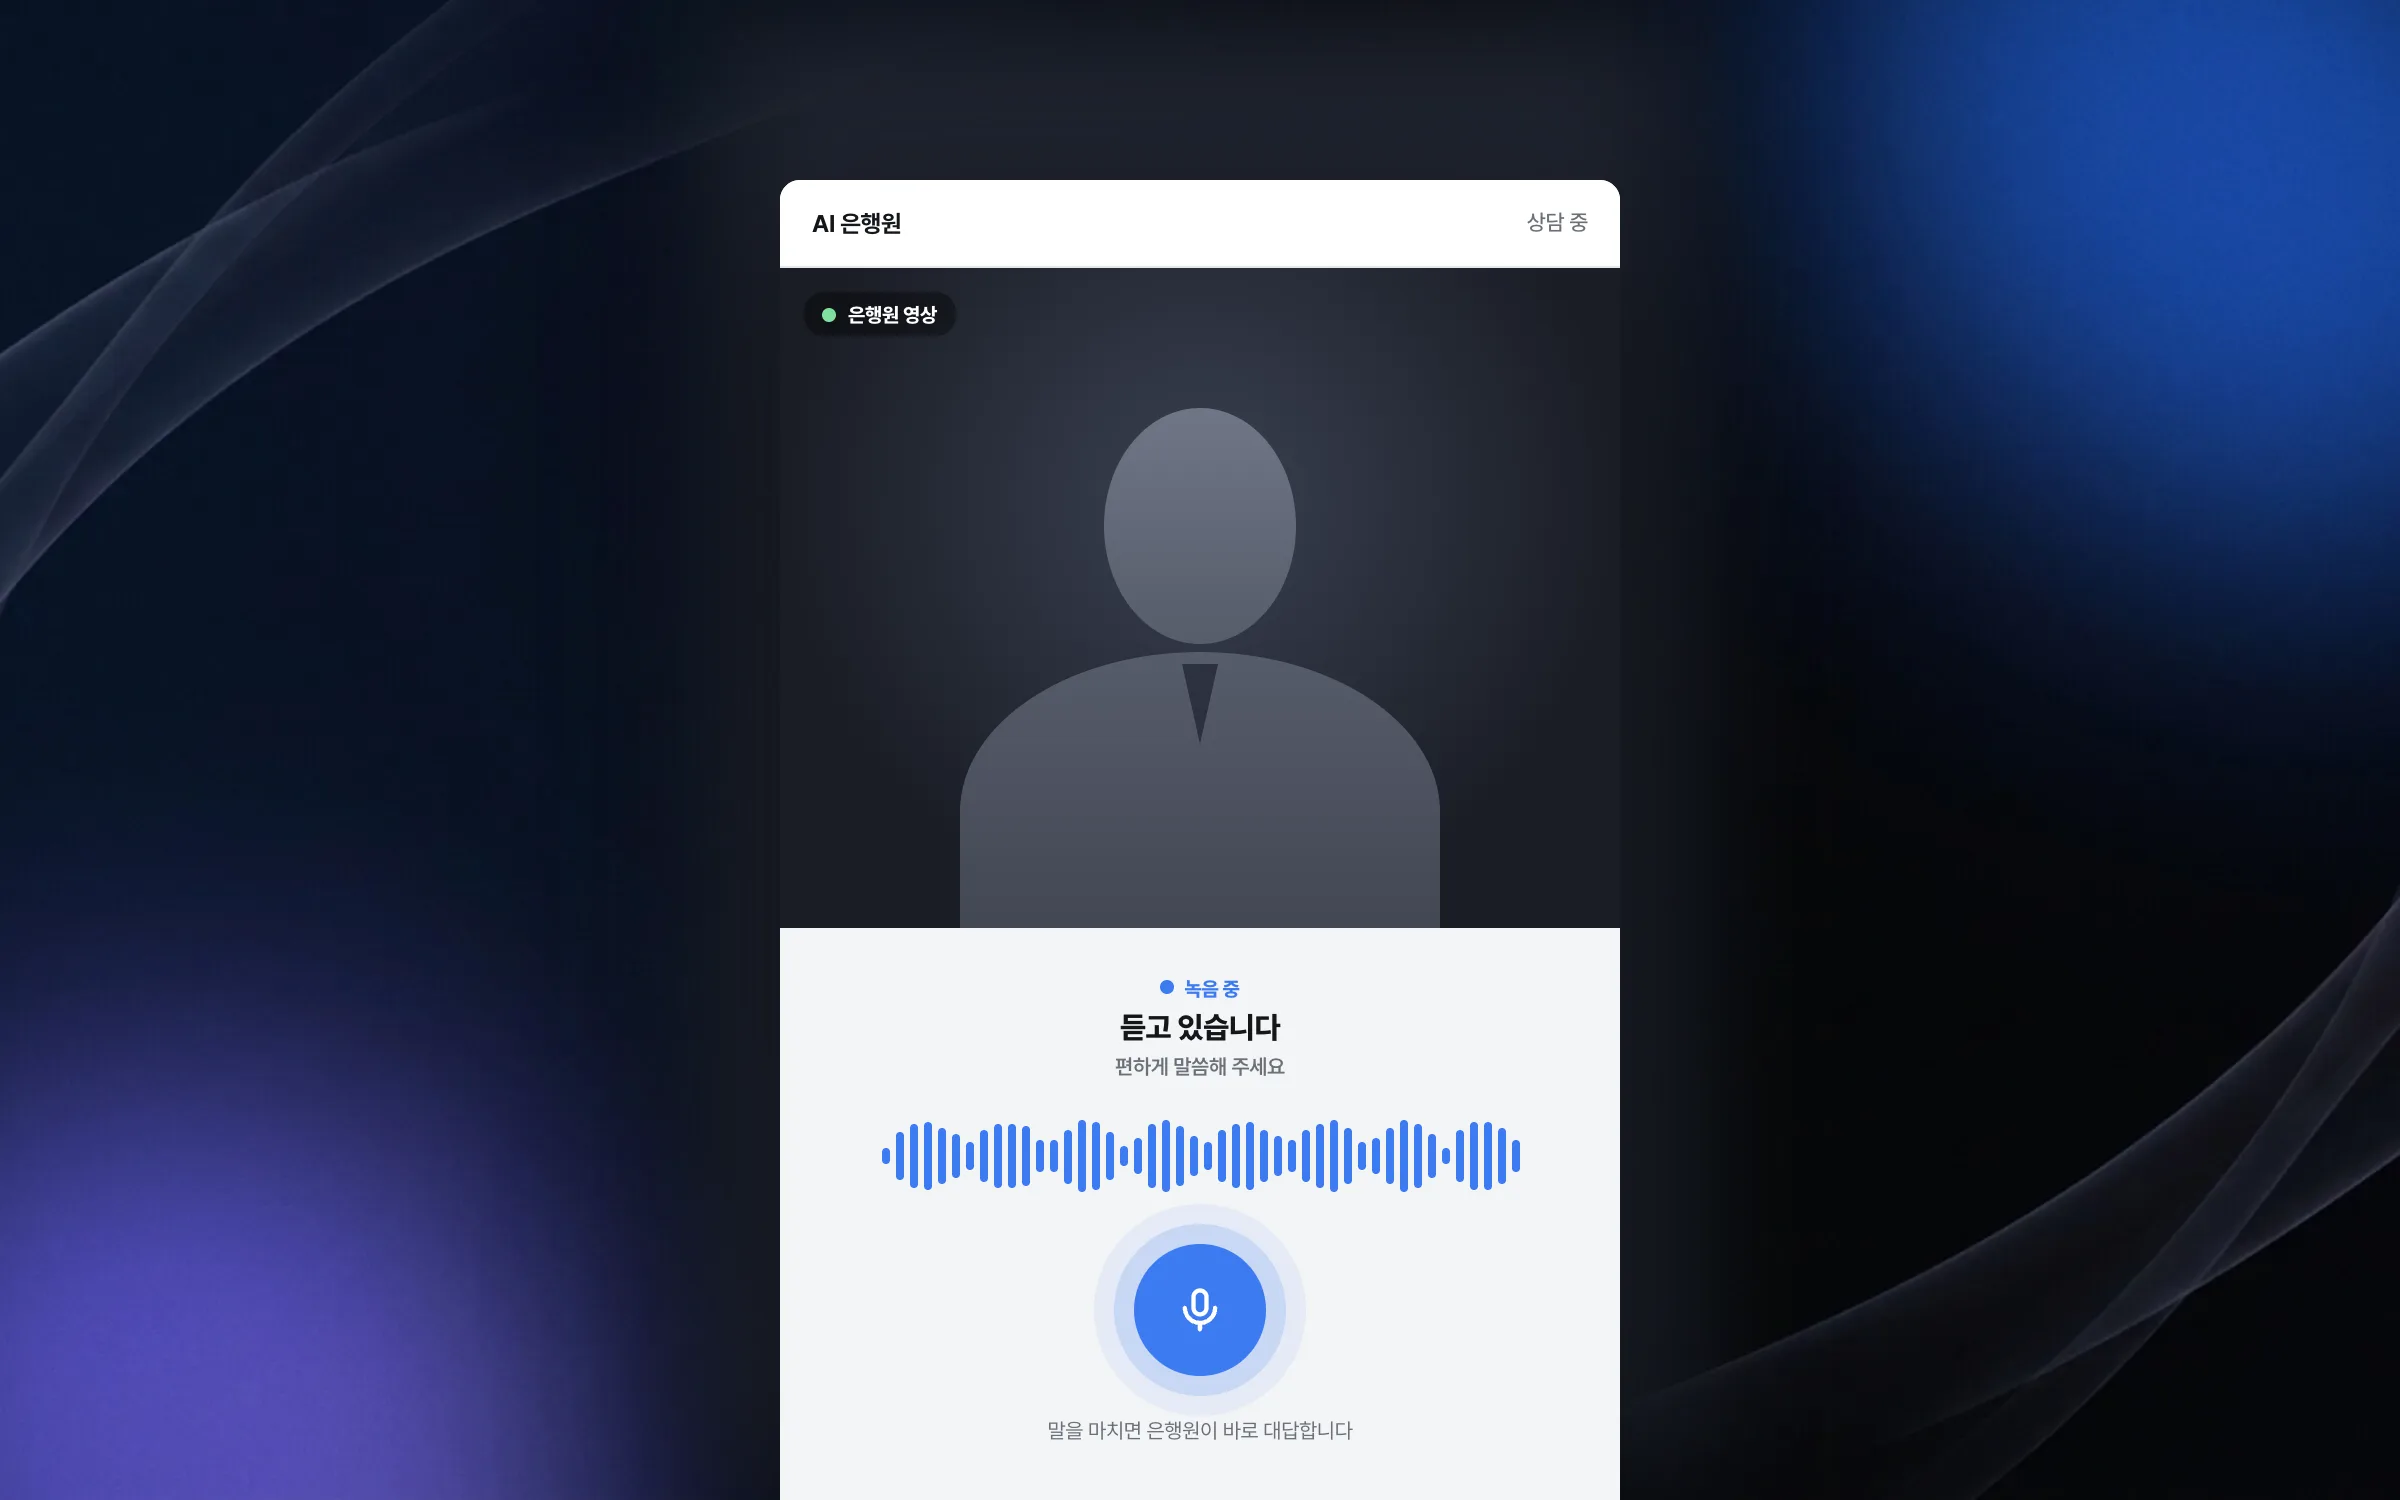
说话期间不间断采集的语音输入
AI 柜员应用实时接收客户对着麦克风说的话,并转换成适合发送到服务器的原始音频数据。为避免客户说话时声音中断或滞后,我们调整了存放输入的缓冲区和发送时机。语音识别在服务器端进行,应用漏掉的声音,AI 也听不到。

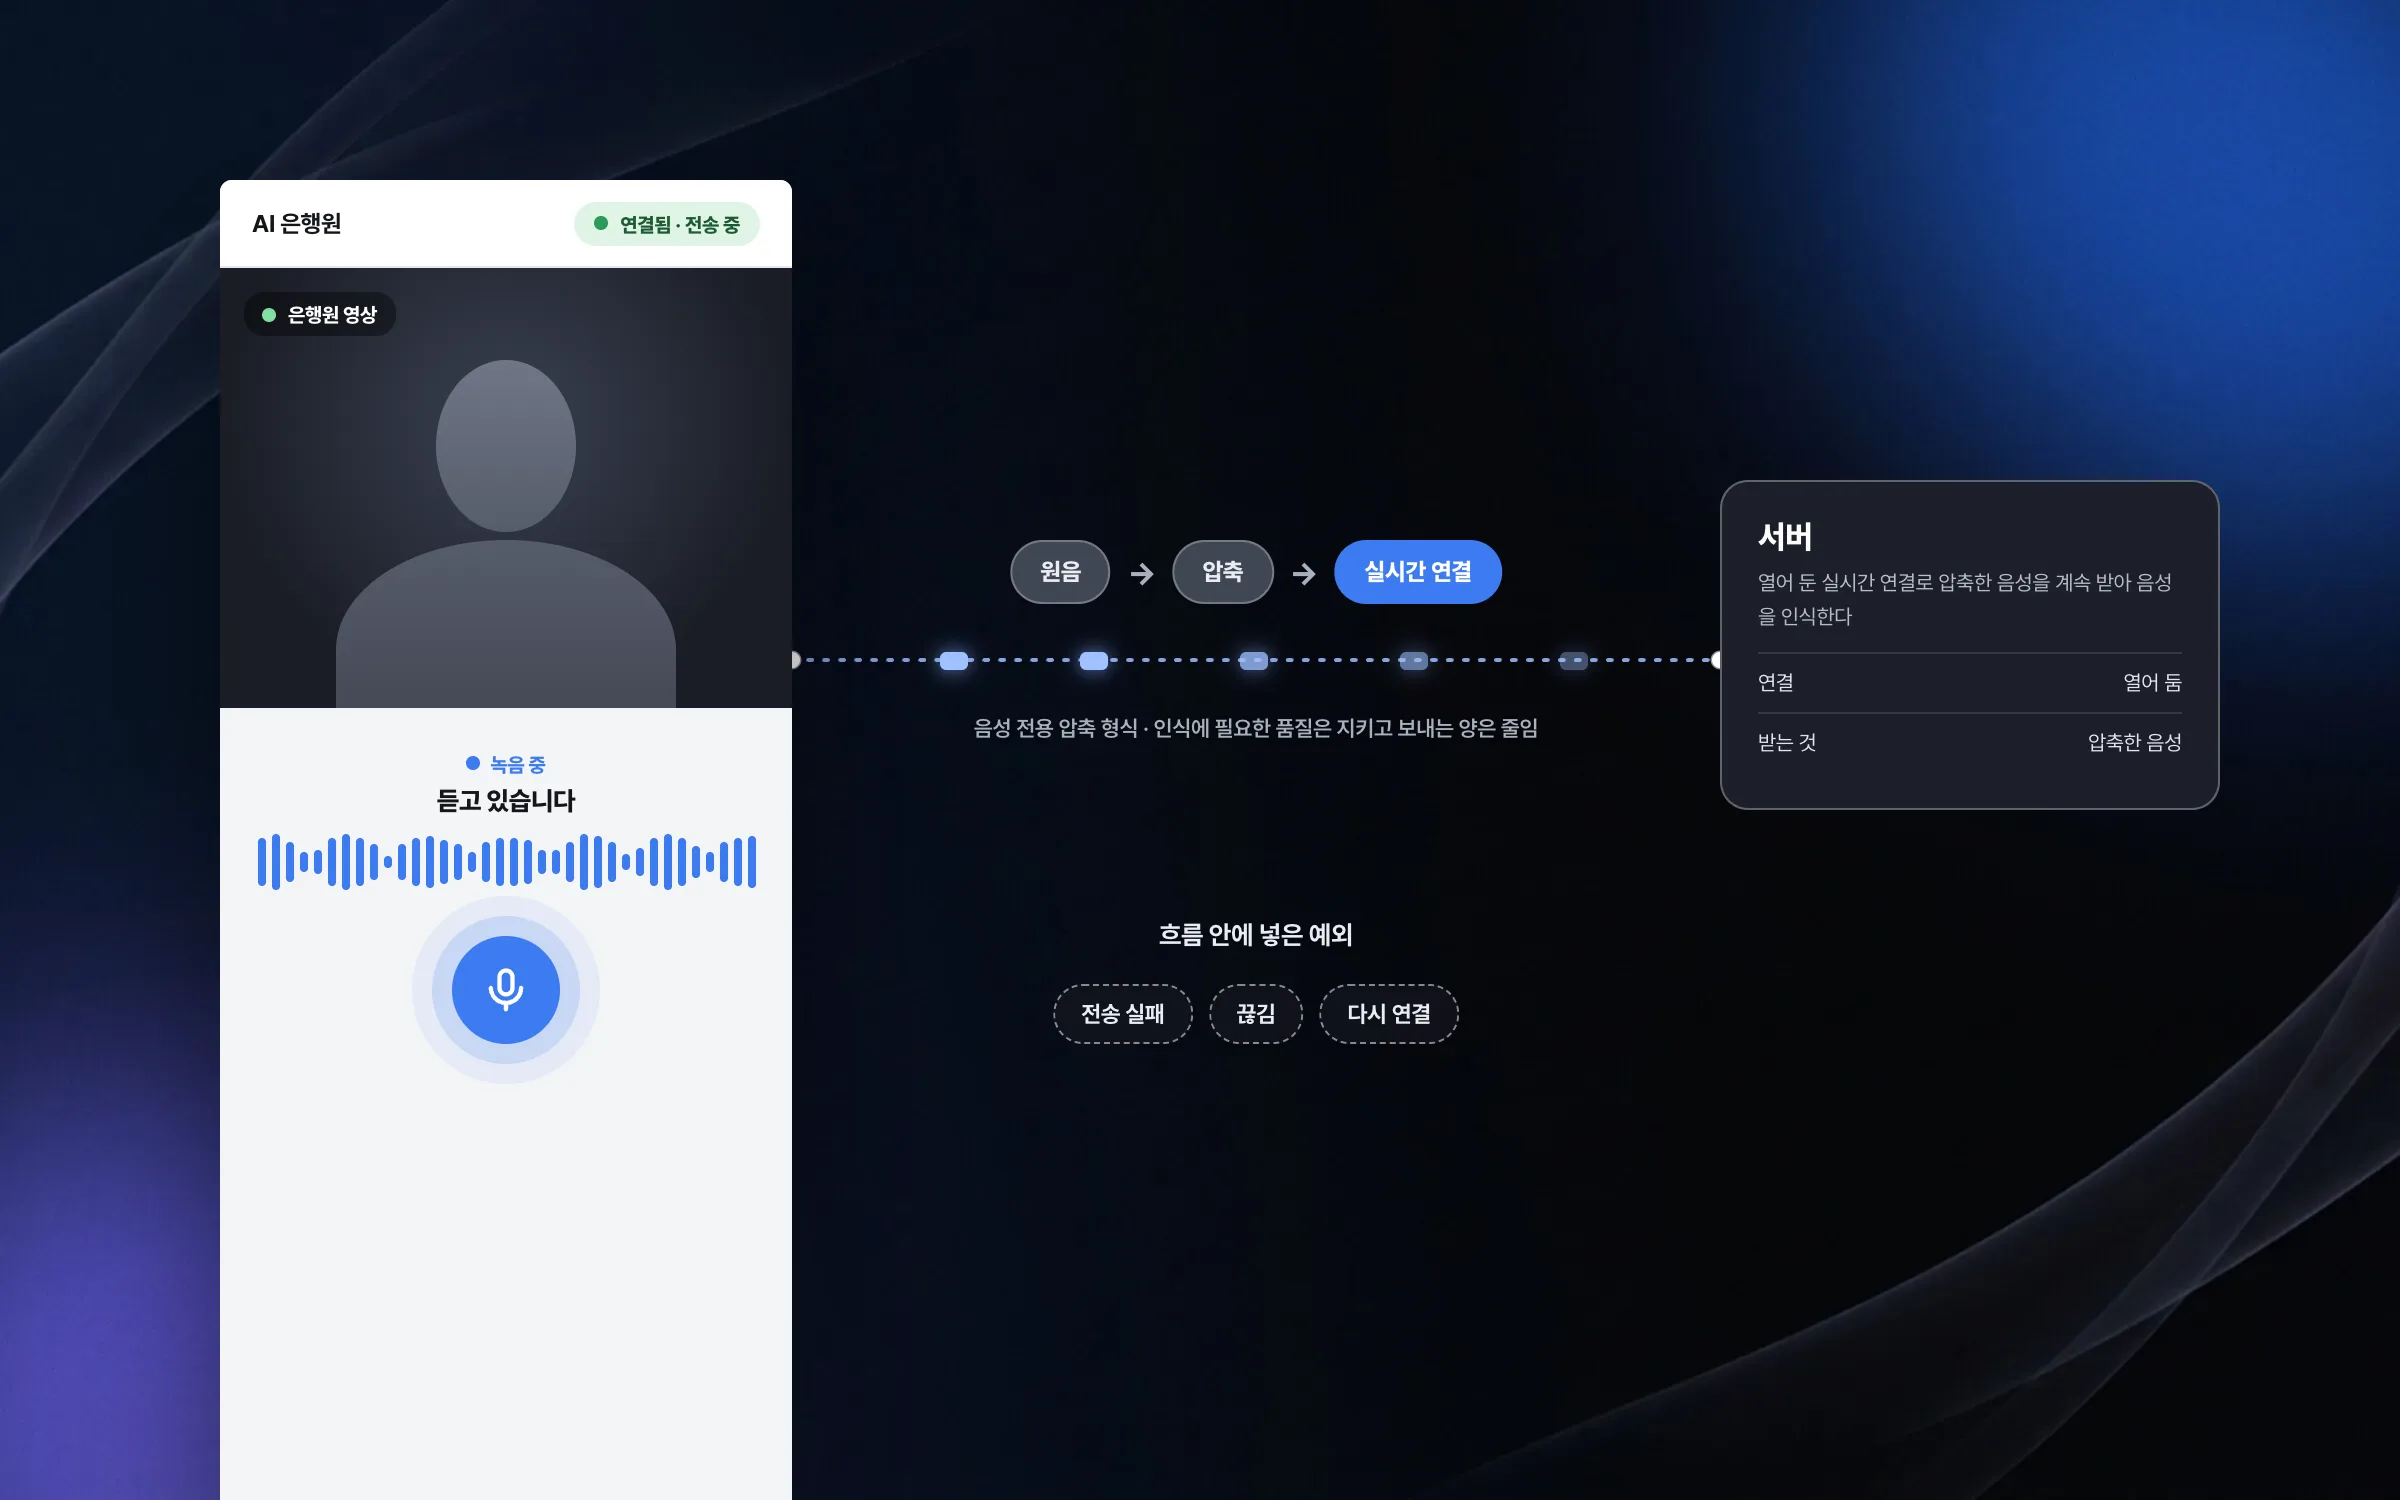
压缩语音并通过实时连接传送
AI 柜员应用把接收到的原始音频用语音专用的压缩格式缩小后发送到服务器。我们整理了压缩过程和数据包的流转,在保证语音识别所需质量的同时,减少通过网络发送的数据量。压缩后的语音通过与服务器保持打开的实时连接持续传送。连接状态、发送失败、断线和重新连接等异常情况,也都纳入了流程之中。

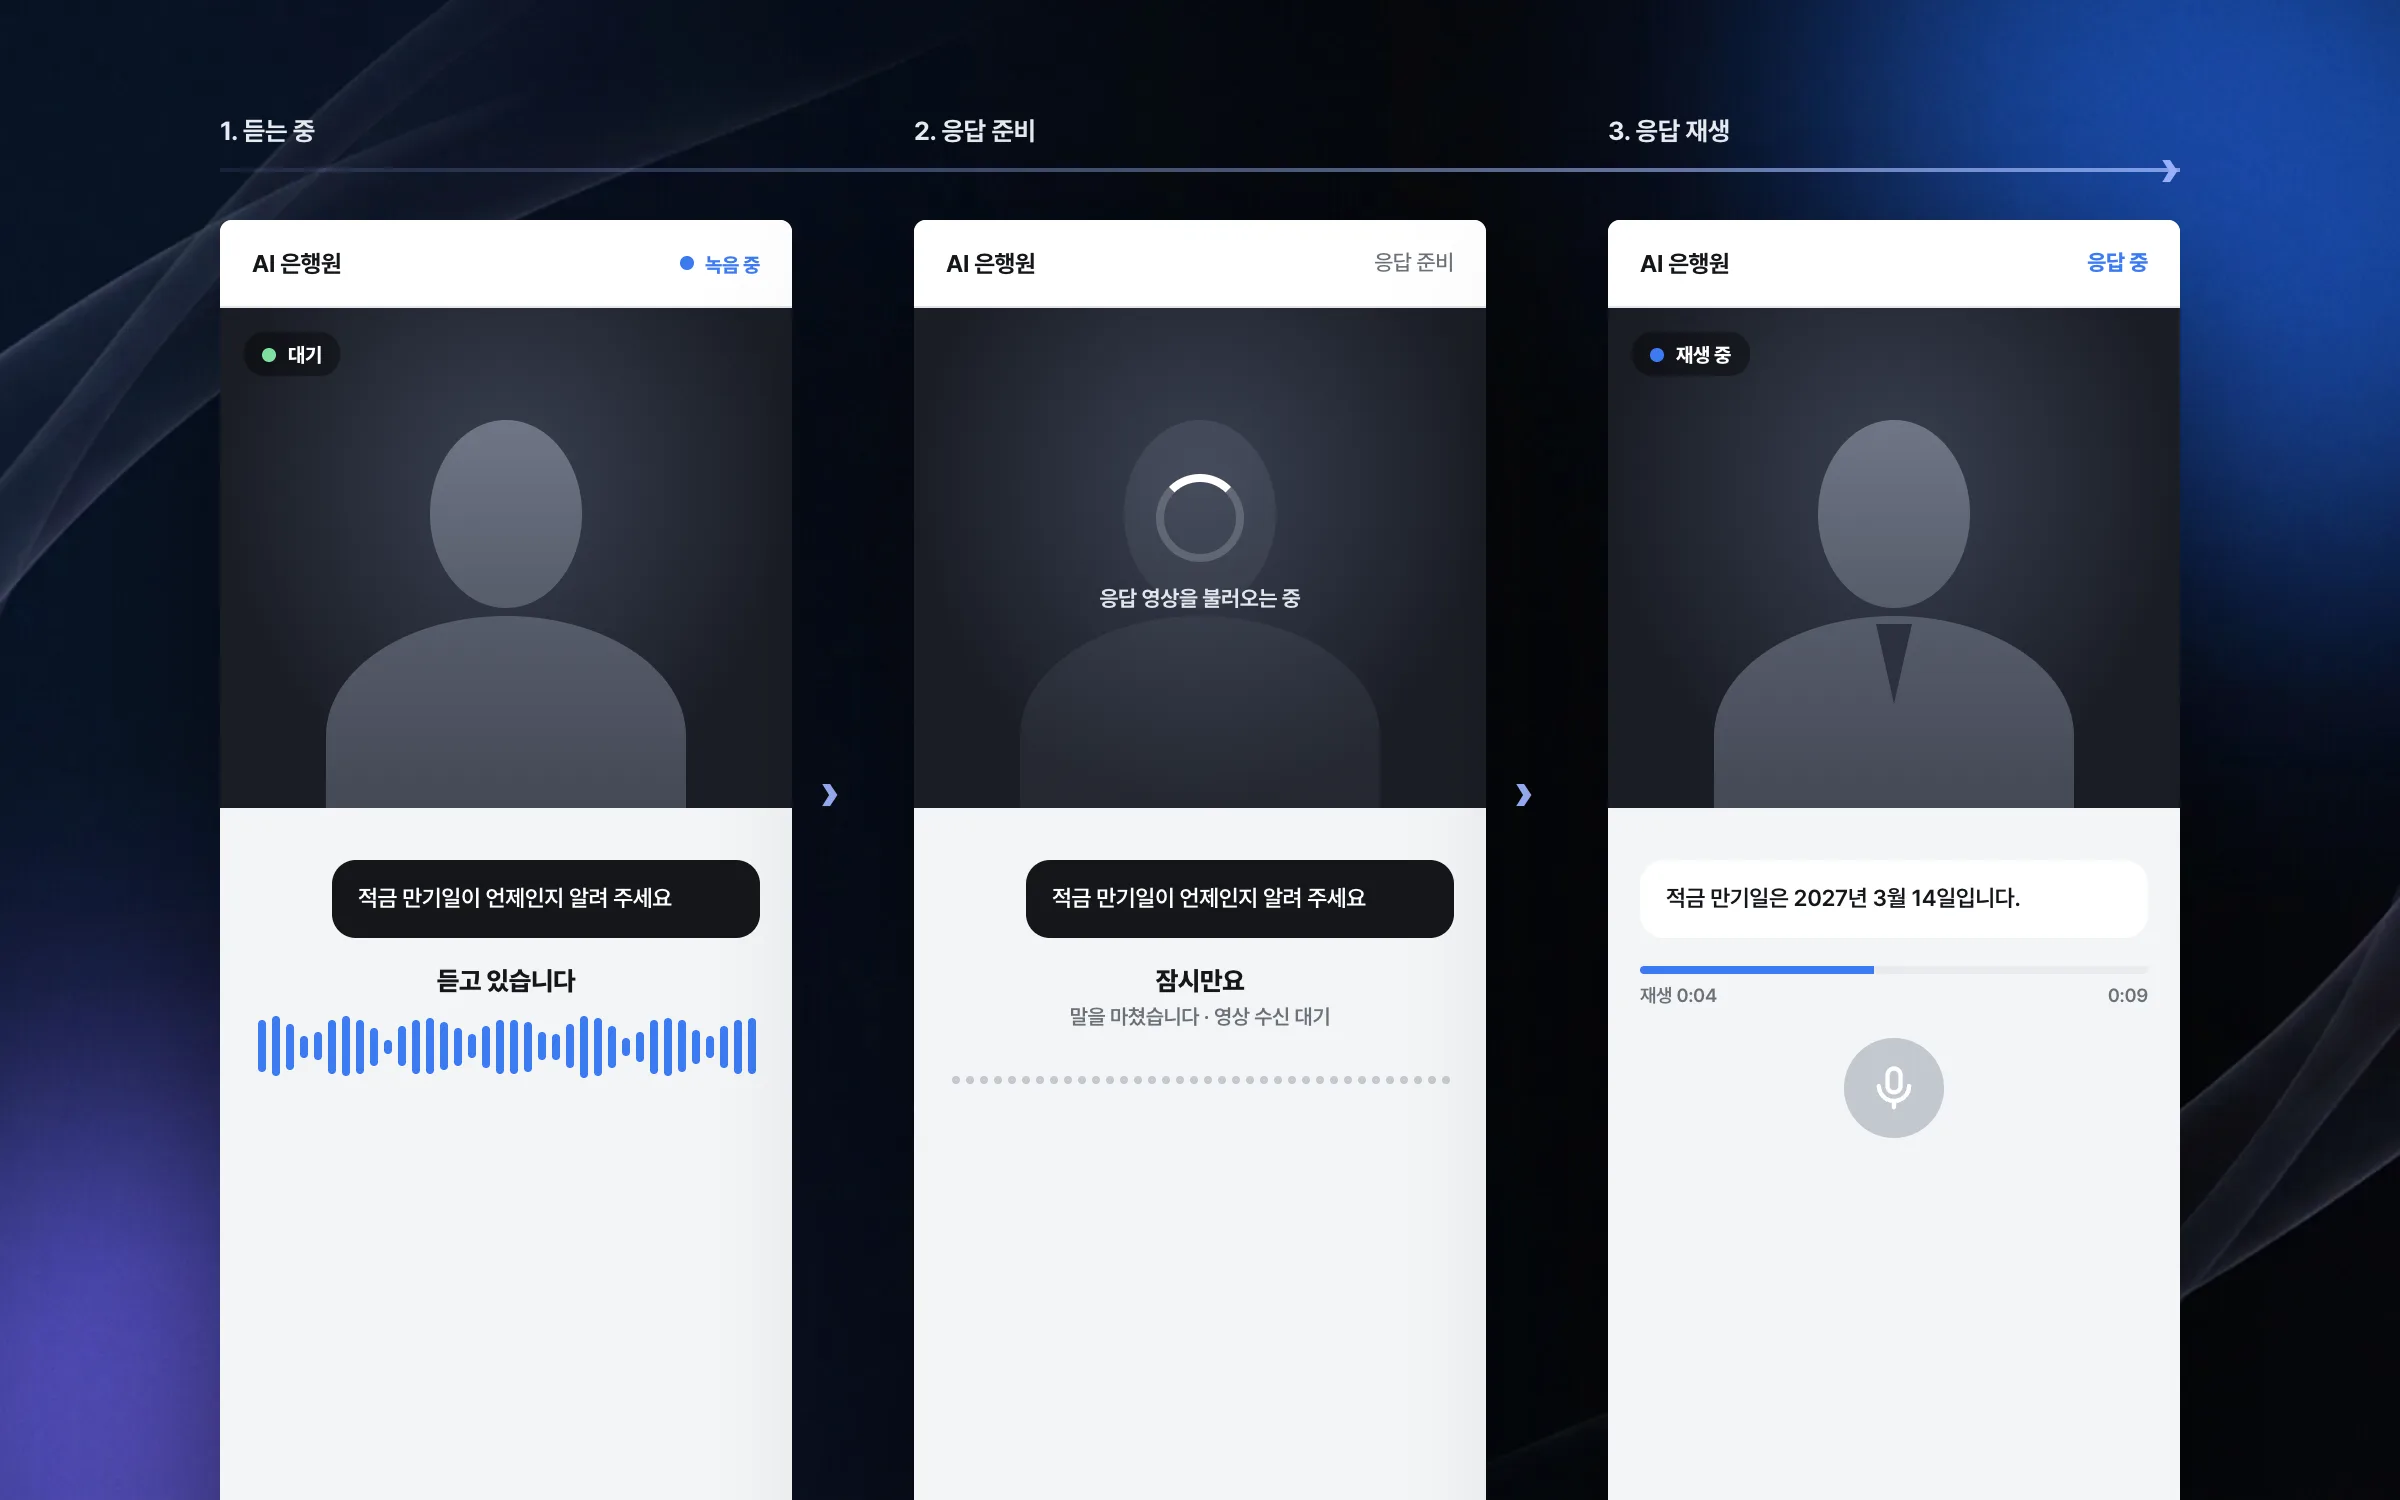
即时衔接服务器生成柜员视频的应答播放
AI 柜员的回答以服务器生成的合成视频返回。应用通过低延迟的实时视频传输方式接收并播放这段视频。视频中的柜员是以真人为原型制作的虚拟人物,通过语音合成与视频合成,针对客户的问题作答。为了让客户说完话后应答视频自然衔接,视频接收、播放状态和界面显示都由应用处理。我们专注于减少发送语音一侧与接收视频一侧之间不必要的等待和状态不一致。

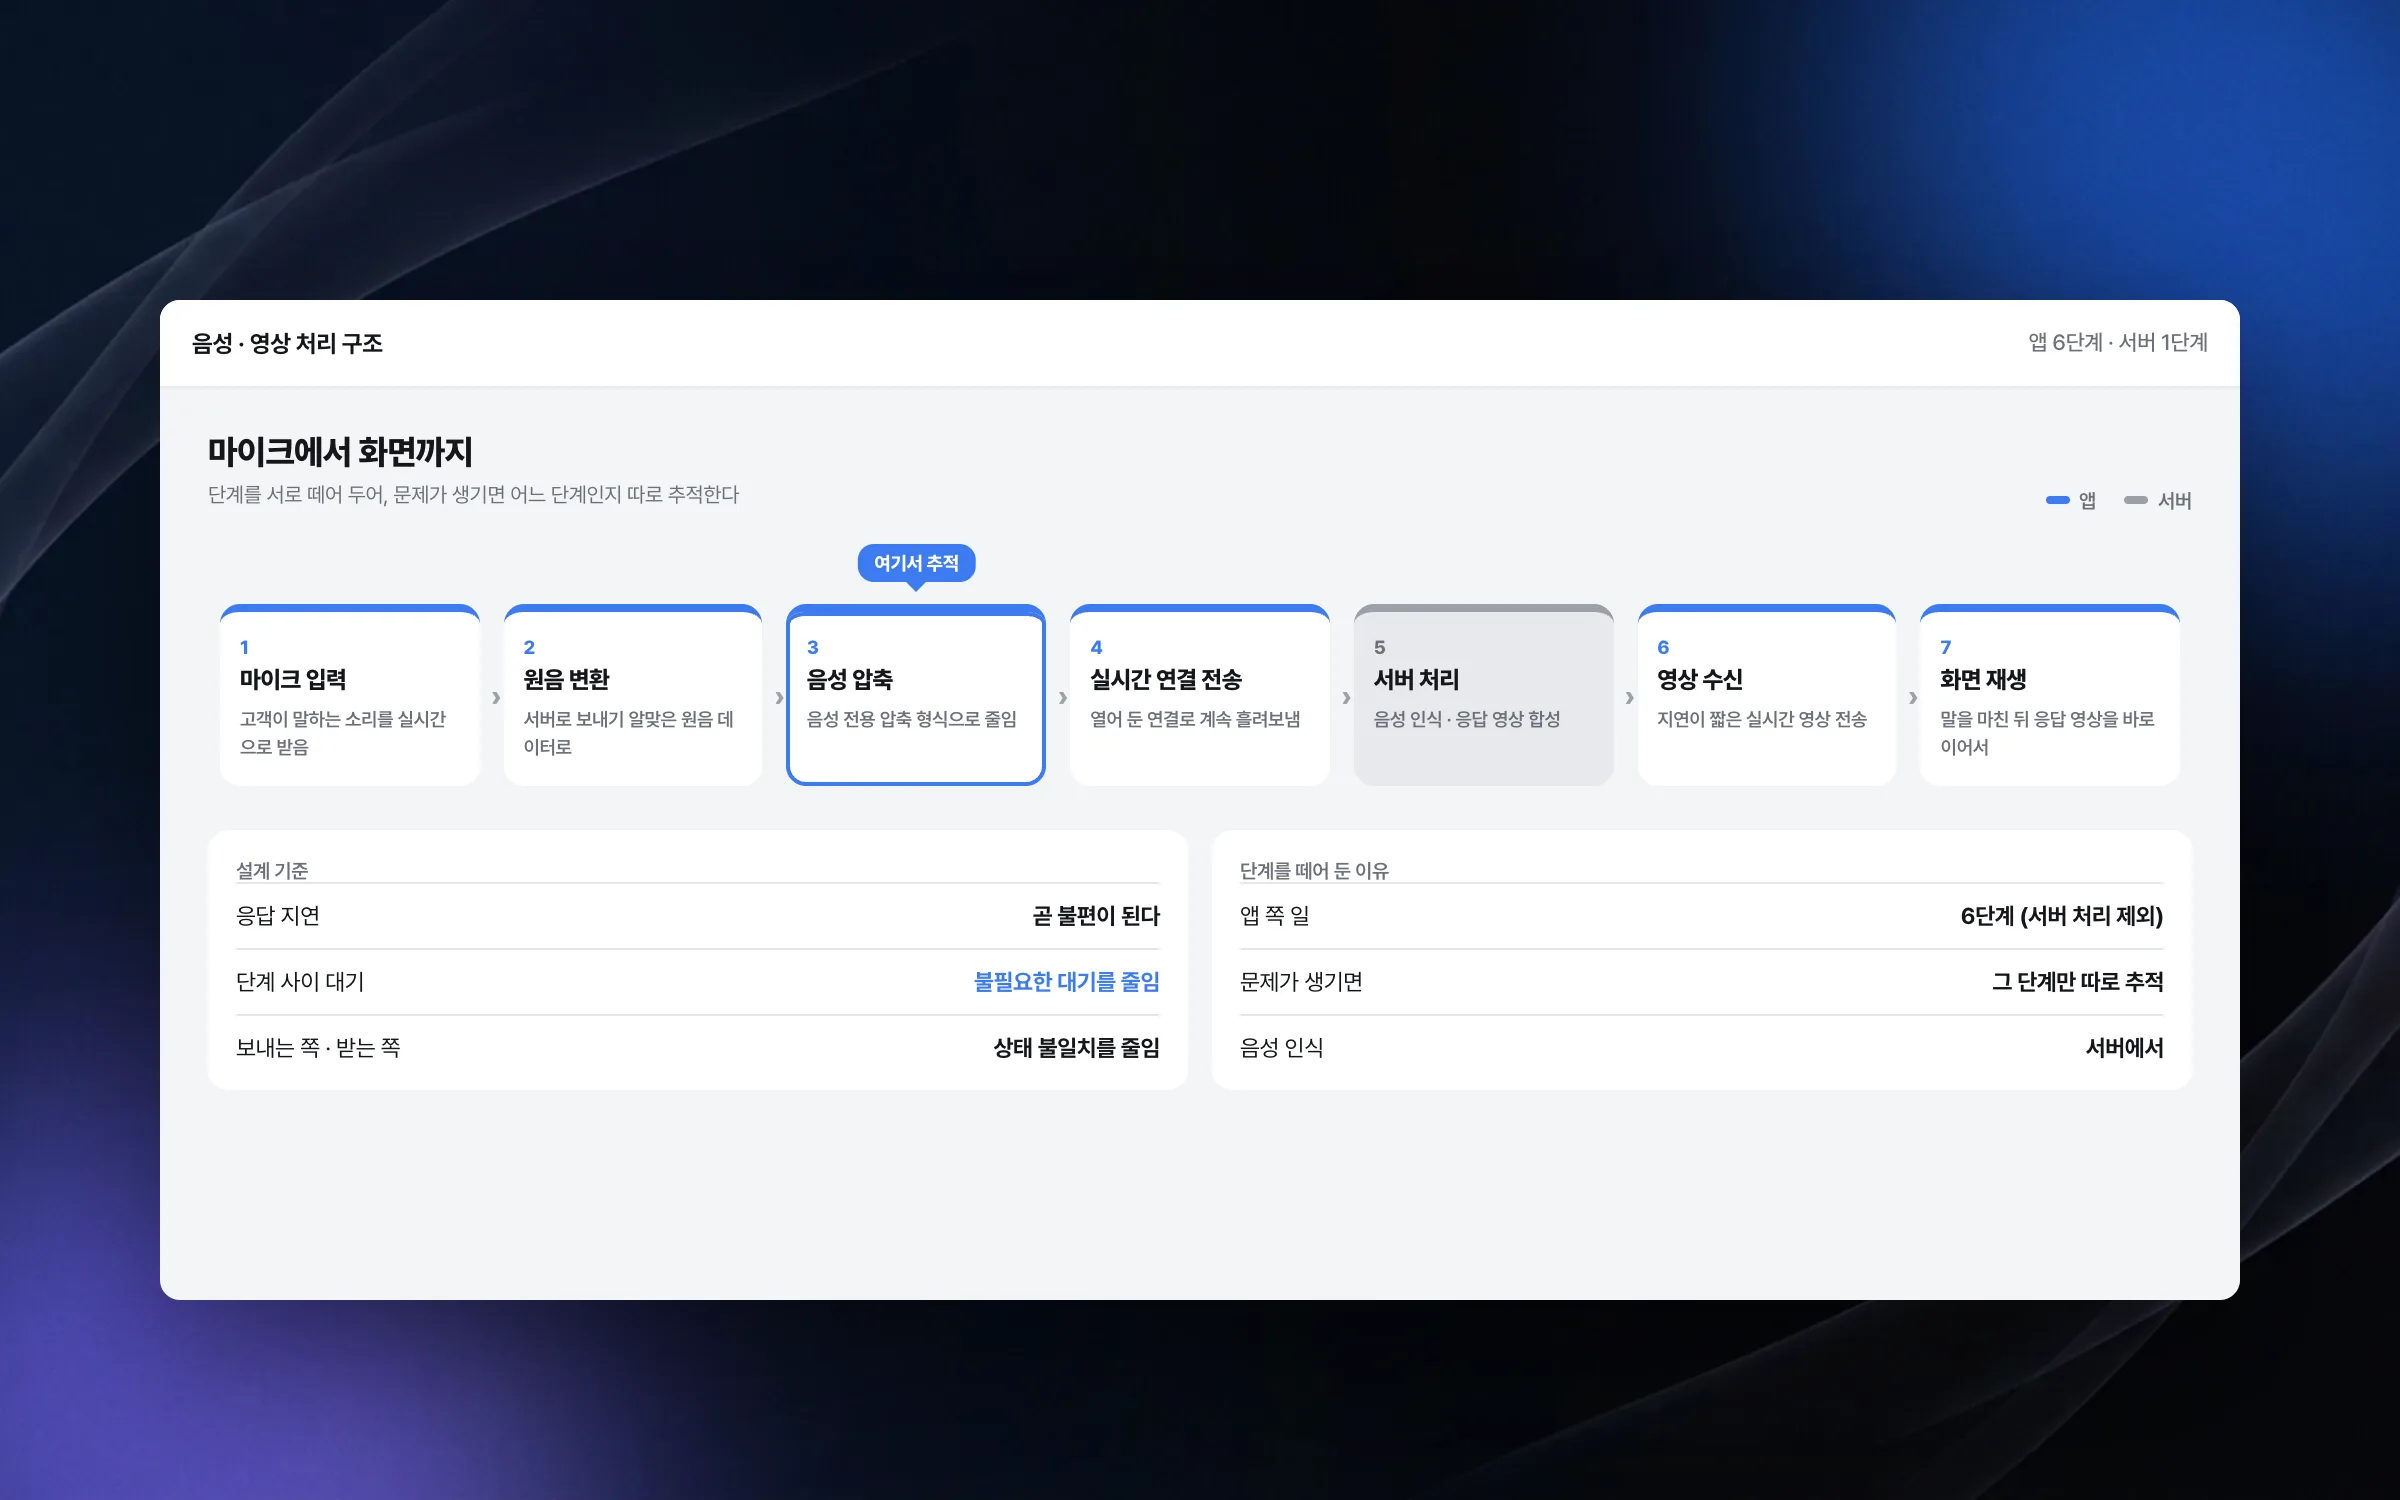
从麦克风到视频分为七个阶段的处理结构
AI 柜员的语音与视频处理分为七个阶段:麦克风输入、原始音频转换、语音压缩、通过实时连接传输、服务器处理、视频接收和画面播放。除服务器处理外的六个阶段属于应用端工作,我们把它们彼此分开,一旦出现问题,就能单独追踪是哪个阶段出的错。在这项服务中,应答延迟直接变成不便,因此减少阶段之间不必要的等待是设计的标准。

项目亮点
压缩麦克风语音并不间断发送到服务器的实时传输
以低延迟接收并立即播放服务器生成的柜员应答视频
从麦克风到视频分阶段、可追踪问题位置的处理结构
洞察
GA4 client_storage: 'none'은 정말 쿠키를 막을까?
두 달 전 이 블로그에 「GA4 쿠키 없이 쓰기」라는 글을 썼습니다. clientstorage: 'none' 으로 쿠키 저장을 끄고, 자체 분석이 쓰던 익명 ID 를 clientid 로 넘기면 쿠키 0개로 GA4 를 쓸 수 있다는 내…
GA4 Measurement Protocol: gtag.js 없이 서버에서 이벤트 보내기
랜딩 페이지의 전송량을 파일 단위로 쪼개 보다가, 가장 큰 파일이 우리 코드가 아니라는 것을 알았습니다. Google Analytics 의 gtag.js 였고, 방문 한 번에 176KB 를 받고 있었습니다. 페이지 전체가 1,094K…
중소 제조업 AI 도입 순서: DX를 먼저 끝내야 할까?
공장을 가진 중소·중견 제조기업 16만여 곳 가운데 스마트공장을 도입한 곳은 19.5%입니다. 회사가 작을수록 이 비율은 더 떨어집니다. 중소벤처기업부가 2025년 4월에 낸 제1차 스마트제조혁신 실태조사 결과입니다. 그림: 기업 규…
Next.js loading.tsx와 404: 버튼이 화면보다 먼저 살아나게 하기
관리 화면 왼쪽 위에 사이드바를 접고 펴는 ☰ 버튼이 있습니다. 폭 하나 바꾸는 버튼인데, 대시보드에서 누르면 2초 넘게 아무 반응이 없었습니다. 레이아웃만 바꾸는 일이 왜 이렇게 오래 걸리는지부터 들여다봤습니다. Next.js 16…